减少重复浏览
先按场景和重复度归类,再由作者挑选真正推动信息的片段。
POSITION
先明确智能辅助能加速什么,再决定是否值得进入工作流。
对素材很多的项目,自动聚类和候选片段可以减少重复浏览;对口语内容,字幕识别能提供第一版文本。但这些功能都无法自动获得人物授权,也无法保证理解创作者真正想表达的语义。工具价值来自“缩短机械步骤”,不是替代创作责任。
先按场景和重复度归类,再由作者挑选真正推动信息的片段。
涉及隐私、授权和争议表达时必须回到原始素材与公开范围人工判断。
TIMELINE
工作流从输入前检查开始:来源不清、授权不明或包含私人信息的素材,不进入后续自动处理。
用主题、场景和可用程度三层标签整理素材,让工具理解前先让作者自己理解。
基础 · 20 分钟自动挑选可减少重复浏览,但候选片段不等于最终叙事。
基础 · 24 分钟字幕识别可以加快初稿,但专有名词、语气和停顿仍需逐句复核。
基础 · 18 分钟节奏优化应先去除信息重复,再判断哪些停顿是情绪和空间的一部分。
进阶 · 22 分钟跳点检查之后仍需完整观看,确认转场、字幕和声音在真实播放中连贯。
进阶 · 26 分钟不预设唯一参数,先以实际发布平台和项目交付要求为准。
进阶 · 19 分钟检查门牌、工牌、聊天窗口和未授权人物,必要时裁切、遮挡或删除。
基础 · 16 分钟用日期、版本与修改说明保存成片,避免最终文件不断覆盖。
基础 · 14 分钟ROUGH CUT
候选结构是草稿,不是答案。先保证信息完整,再判断自动剪点是否破坏动作、因果或人物关系。
系统识别到停顿并压缩了两秒,却把人物从“问题”转向“解释”的呼吸一起删掉。
保留语义转折前的短停顿,把后面重复说明的句子移出主线,成片反而更清楚。
SUBTITLE
自动识别先做初稿,人名、术语、断句和语气必须逐句校对。
“现场先保留环境声,后段若显得太满,再逐步减弱。”
先保留环境声。
后段太满时,再逐步减弱。
不能把“先留下”误成“先删掉”;断句要跟语义走,而不是只按停顿时长。
RHYTHM
先删信息重复,再决定停顿是否冗余。访谈、生活记录和教程对“快”的需要并不相同。
教程需要给观众跟上步骤的时间,人物访谈需要保留思考和语气,生活记录则可能依赖环境声建立空间。统一加速会损失这些差异。更稳妥的方法是先确定每段承担的功能,再调整镜头长度。
MANUAL REVIEW
自动流程结束后分三轮检查,每轮只关注一类问题。
完整观看,确认因果、人物关系和重要信息没有被错切。
检查人名、断句、安全区、门牌、工牌、聊天窗口和未授权人物。
闭眼听一遍对白、环境声与峰值,找出突兀静音和音量跳变。
EXPORT
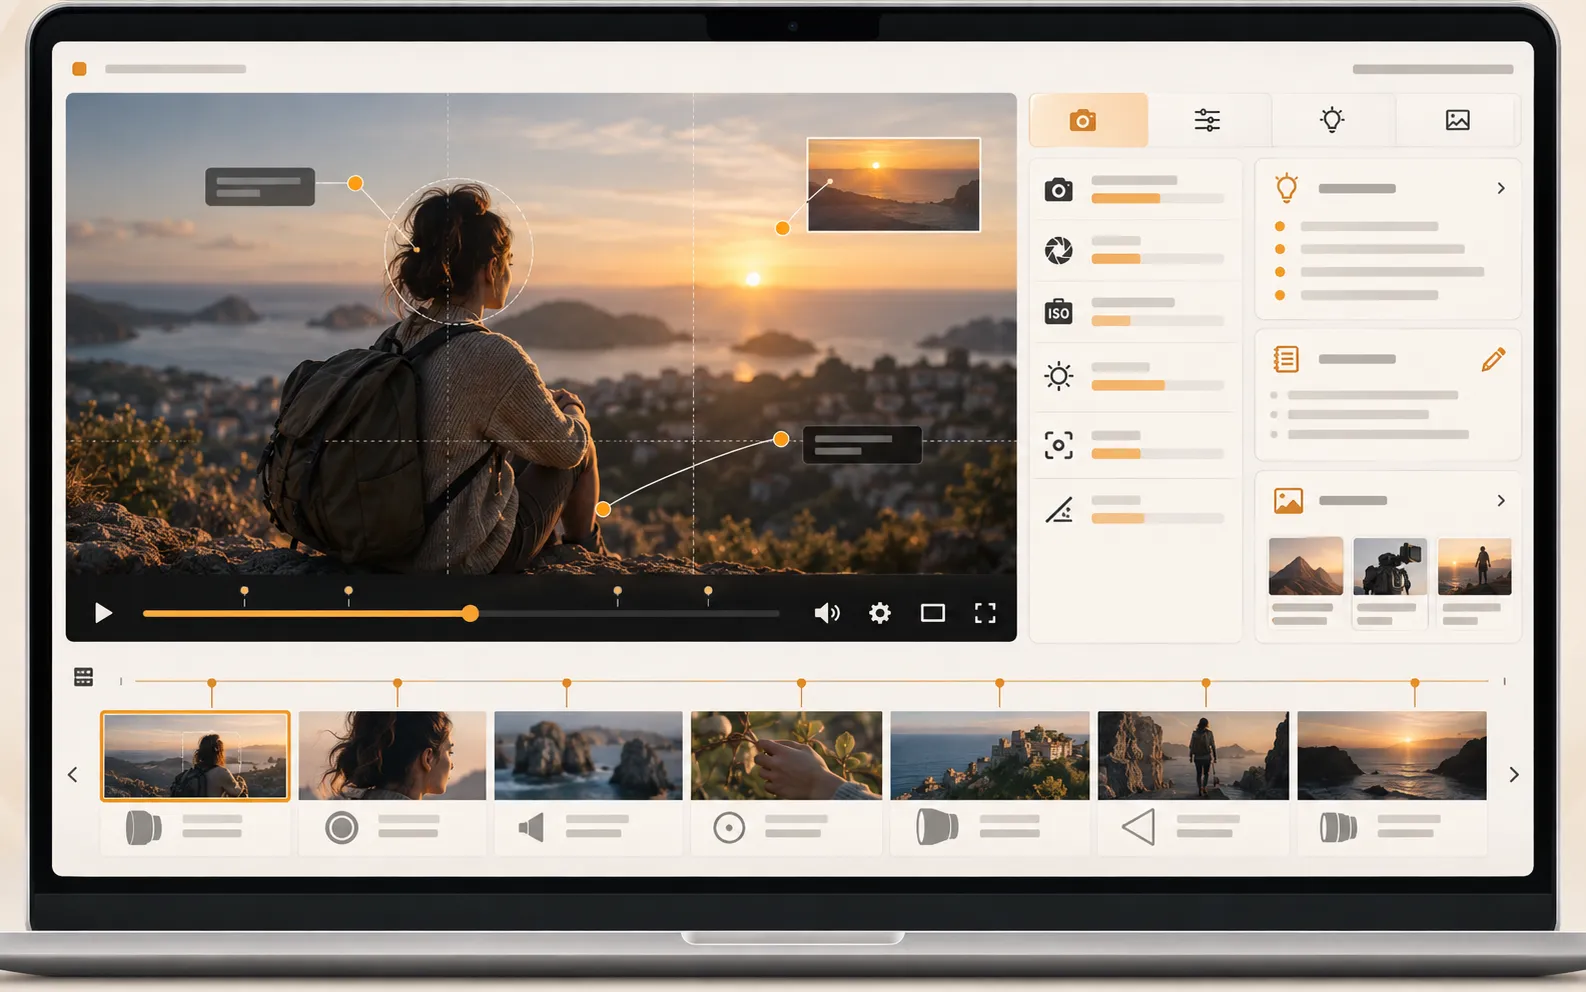
不存在对所有项目都最优的单一参数。先看发布环境、交付要求与原始素材,再确认画幅、帧率、码率与字幕安全区。
横屏、竖屏或方形都要回到内容构图与平台规范。
避免无理由转换造成节奏或运动观感变化。
不同段落不要突然变得过响或过轻。
记录版本和修改说明,避免只剩压缩后的发布文件。
PRIVACY
素材进入任何智能流程之前,先确认它是否适合处理和公开。
包含证件、住址、私人聊天、医疗信息、未成年人敏感信息或非公开行程的素材,不应因为工具“能识别”就进入工作流。画面边缘的门牌、工牌和聊天窗口也需要单独检查。无法确认人物授权时,最稳妥的做法是暂缓使用。
查看隐私中心FAQ
关于自动化边界、字幕、人工复核和隐私的常见问题。
不会把 AI 描述成可以完全替代作者。页面展示的是素材整理、智能粗剪、字幕辅助、节奏优化、人工复核和导出检查等工作流。自动结果只能作为候选或草稿,叙事判断、授权确认和最终质量仍需要人工负责。
不会。浏览器页面只说明内容导航、清爽阅读、沉浸观看、标签管理与透明隐私设置等能力,不宣称绝对安全、完全匿名、绕过监管或突破限制。任何隐私能力都应明确适用范围和用户仍需承担的安全责任。
收藏仅保存在当前浏览器。本地存储不可用时不会影响正文浏览。